THE ANNOTATED TRANSFORMER · STEP BY STEP
빈 파일에서 번역기까지,
Transformer 코드가 자라는 과정
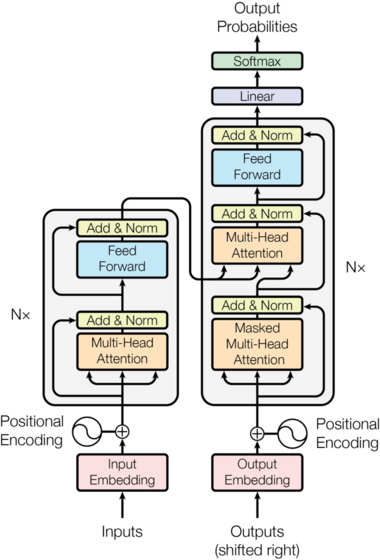
The Annotated Transformer는 논문을 코드 한 줄 한 줄로 옮긴 명작이지만, 노트북이 전체 구조(EncoderDecoder)부터 보여 줘서 처음 읽을 때 어디서부터 봐야 할지 막막하다. 이 페이지는 순서를 거꾸로 한다. 어텐션 함수 한 줄짜리 빈 파일에서 시작해 부품을 하나씩 더하고, 단계마다 바뀐 코드와 그 코드를 실제로 돌린 결과를 나란히 보여 준다. 18단계를 넘기면 원본과 같은 코드가 완성되고, 그 코드로 독일어를 영어로 번역한다.
01단계부터 시작 →페이지에서 ← →로 넘길 수 있다
단계별 transformer.py 줄 수
막대를 누르면 그 단계로 간다.
읽는 법
- 코드를 직접 칠 필요는 없다. 단계마다 이전 단계와의 diff가 있고, 탭을 바꾸면 그 시점의 파일 전체를 볼 수 있다.
- 실행 결과는 진짜다. 각 단계의
demo.py를 그 단계의 코드로 실행한 출력이다. 17·18단계(GPU 학습)만 RTX 3070에서 실행한 기록을 가져왔다. - 코드는 원본 그대로다. 순서만 바꿔 쌓았다. 원본과 다른 곳(torchtext 대체 등)은 해당 단계 설명에 적었다.
- 원문(논문 + 주석)을 같이 보고 싶다면 단계마다 붙은 한국어 번역판 링크를 따라가면 된다.
1부 · 모델 만들기
- 01어텐션 한 줄부터softmax(QKᵀ/√d)V 한 줄11줄
- 02보면 안 되는 칸 가리기미래와 패딩을 가리는 마스크22줄
- 03머리를 여러 개로: Multi-Head Attention어텐션 8개를 한 번에73줄
- 04토큰마다 혼자 생각하기: Feed-Forward토큰마다 따로 도는 2층 MLP86줄
- 05단어를 벡터로, 순서를 신호로단어 id → 벡터, 순서 → 사인파119줄
- 06깊게 쌓아도 무너지지 않게: LayerNorm과 잔차 연결잔차 연결과 LayerNorm150줄
- 07인코더: 같은 층을 6번같은 층을 6번 쌓은 인코더181줄
- 08디코더: 원문을 보면서, 미래는 보지 않고원문을 보는 어텐션이 더해진 디코더214줄
- 09하나로 조립: EncoderDecoder와 make_model부품 다섯 개를 하나로275줄
- 10한 단어씩 생성하기: greedy decoding한 토큰씩 고르는 생성291줄