| 1 | import math |
| 2 | |
| 3 | import torch |
| 4 | |
| 5 | from transformer import attention |
| 6 | |
| 7 | torch.manual_seed(0) |
| 8 | |
| 9 | # 토큰 3개짜리 문장 하나. 토큰마다 4차원 벡터. |
| 10 | x = torch.randn(1, 3, 4) |
| 11 | |
| 12 | # self-attention: query, key, value를 모두 같은 x로 |
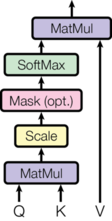
| 13 | out, p_attn = attention(x, x, x) |
| 14 | |
| 15 | print("입력 x :", tuple(x.shape), " (batch, 토큰 수, d_k)") |
| 16 | print("출력 :", tuple(out.shape)) |
| 17 | print("가중치 p_attn:", tuple(p_attn.shape), " (batch, query 토큰, key 토큰)") |
| 18 | print() |
| 19 | print("어텐션 가중치 — i행은 'i번째 토큰이 각 토큰을 얼마나 참고하는가'") |
| 20 | print(p_attn[0].round(decimals=3)) |
| 21 | print("행마다 합:", [f"{v:.3f}" for v in p_attn[0].sum(-1).tolist()]) |
| 22 | print() |
| 23 | print("출력 0번 토큰 = 가중치로 섞은 value") |
| 24 | manual = sum(p_attn[0, 0, j] * x[0, j] for j in range(3)) |
| 25 | print(" attention() :", [f"{v:.4f}" for v in out[0, 0].tolist()]) |
| 26 | print(" 직접 계산 :", [f"{v:.4f}" for v in manual.tolist()]) |
| 27 | print() |
| 28 | |
| 29 | print("왜 √d_k로 나누는가 — 성분이 평균 0·분산 1인 q, k의 내적은 분산이 d_k가 된다") |
| 30 | for d_k in (4, 64, 512): |
| 31 | q, k = torch.randn(10000, d_k), torch.randn(10000, d_k) |
| 32 | dots = (q * k).sum(-1) |
| 33 | print( |
| 34 | f" d_k={d_k:3d} q·k 표준편차 {dots.std():6.2f}" |
| 35 | f" → √d_k로 나누면 {(dots / math.sqrt(d_k)).std():.2f}" |
| 36 | ) |
| 37 | print() |
| 38 | q, k = torch.randn(1, 512), torch.randn(10, 512) |
| 39 | raw = (q @ k.T).softmax(-1) |
| 40 | scaled = (q @ k.T / math.sqrt(512)).softmax(-1) |
| 41 | print("d_k=512, key 10개일 때 softmax 결과") |
| 42 | print(" 나누지 않으면:", " ".join(f"{v:.3f}" for v in raw[0].tolist())) |
| 43 | print(" √d_k로 나누면:", " ".join(f"{v:.3f}" for v in scaled[0].tolist())) |
| 44 | print(" → 나누지 않으면 한 칸에 거의 다 몰려서(포화) 기울기가 사라진다") |