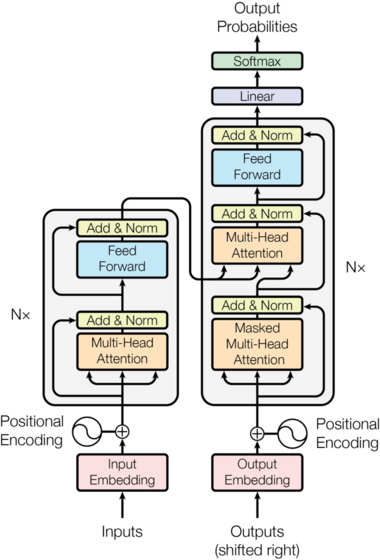
| 1 | import copy |
| 2 | import math |
| 3 | |
| 4 | import torch |
| 5 | import torch.nn as nn |
| 6 | |
| 7 | |
| 8 | def attention(query, key, value, mask=None, dropout=None): |
| 9 | "Compute 'Scaled Dot Product Attention'" |
| 10 | d_k = query.size(-1) |
| 11 | scores = torch.matmul(query, key.transpose(-2, -1)) / math.sqrt(d_k) |
| 12 | if mask is not None: |
| 13 | scores = scores.masked_fill(mask == 0, -1e9) |
| 14 | p_attn = scores.softmax(dim=-1) |
| 15 | if dropout is not None: |
| 16 | p_attn = dropout(p_attn) |
| 17 | return torch.matmul(p_attn, value), p_attn |
| 18 | |
| 19 | |
| 20 | def subsequent_mask(size): |
| 21 | "Mask out subsequent positions." |
| 22 | attn_shape = (1, size, size) |
| 23 | subsequent_mask = torch.triu(torch.ones(attn_shape), diagonal=1).type( |
| 24 | torch.uint8 |
| 25 | ) |
| 26 | return subsequent_mask == 0 |
| 27 | |
| 28 | |
| 29 | def clones(module, N): |
| 30 | "Produce N identical layers." |
| 31 | return nn.ModuleList([copy.deepcopy(module) for _ in range(N)]) |
| 32 | |
| 33 | |
| 34 | class MultiHeadedAttention(nn.Module): |
| 35 | def __init__(self, h, d_model, dropout=0.1): |
| 36 | "Take in model size and number of heads." |
| 37 | super(MultiHeadedAttention, self).__init__() |
| 38 | assert d_model % h == 0 |
| 39 | # We assume d_v always equals d_k |
| 40 | self.d_k = d_model // h |
| 41 | self.h = h |
| 42 | self.linears = clones(nn.Linear(d_model, d_model), 4) |
| 43 | self.attn = None |
| 44 | self.dropout = nn.Dropout(p=dropout) |
| 45 | |
| 46 | def forward(self, query, key, value, mask=None): |
| 47 | "Implements Figure 2" |
| 48 | if mask is not None: |
| 49 | # Same mask applied to all h heads. |
| 50 | mask = mask.unsqueeze(1) |
| 51 | nbatches = query.size(0) |
| 52 | |
| 53 | # 1) Do all the linear projections in batch from d_model => h x d_k |
| 54 | query, key, value = [ |
| 55 | lin(x).view(nbatches, -1, self.h, self.d_k).transpose(1, 2) |
| 56 | for lin, x in zip(self.linears, (query, key, value)) |
| 57 | ] |
| 58 | |
| 59 | # 2) Apply attention on all the projected vectors in batch. |
| 60 | x, self.attn = attention( |
| 61 | query, key, value, mask=mask, dropout=self.dropout |
| 62 | ) |
| 63 | |
| 64 | # 3) "Concat" using a view and apply a final linear. |
| 65 | x = ( |
| 66 | x.transpose(1, 2) |
| 67 | .contiguous() |
| 68 | .view(nbatches, -1, self.h * self.d_k) |
| 69 | ) |
| 70 | del query |
| 71 | del key |
| 72 | del value |
| 73 | return self.linears[-1](x) |
| 74 | |
| 75 | |
| 76 | class PositionwiseFeedForward(nn.Module): |
| 77 | "Implements FFN equation." |
| 78 | |
| 79 | def __init__(self, d_model, d_ff, dropout=0.1): |
| 80 | super(PositionwiseFeedForward, self).__init__() |
| 81 | self.w_1 = nn.Linear(d_model, d_ff) |
| 82 | self.w_2 = nn.Linear(d_ff, d_model) |
| 83 | self.dropout = nn.Dropout(dropout) |
| 84 | |
| 85 | def forward(self, x): |
| 86 | return self.w_2(self.dropout(self.w_1(x).relu())) |
| 87 | |
| 88 | |
| 89 | class Embeddings(nn.Module): |
| 90 | def __init__(self, d_model, vocab): |
| 91 | super(Embeddings, self).__init__() |
| 92 | self.lut = nn.Embedding(vocab, d_model) |
| 93 | self.d_model = d_model |
| 94 | |
| 95 | def forward(self, x): |
| 96 | return self.lut(x) * math.sqrt(self.d_model) |
| 97 | |
| 98 | |
| 99 | class PositionalEncoding(nn.Module): |
| 100 | "Implement the PE function." |
| 101 | |
| 102 | def __init__(self, d_model, dropout, max_len=5000): |
| 103 | super(PositionalEncoding, self).__init__() |
| 104 | self.dropout = nn.Dropout(p=dropout) |
| 105 | |
| 106 | # Compute the positional encodings once in log space. |
| 107 | pe = torch.zeros(max_len, d_model) |
| 108 | position = torch.arange(0, max_len).unsqueeze(1) |
| 109 | div_term = torch.exp( |
| 110 | torch.arange(0, d_model, 2) * -(math.log(10000.0) / d_model) |
| 111 | ) |
| 112 | pe[:, 0::2] = torch.sin(position * div_term) |
| 113 | pe[:, 1::2] = torch.cos(position * div_term) |
| 114 | pe = pe.unsqueeze(0) |
| 115 | self.register_buffer("pe", pe) |
| 116 | |
| 117 | def forward(self, x): |
| 118 | x = x + self.pe[:, : x.size(1)].requires_grad_(False) |
| 119 | return self.dropout(x) |
| 120 | |
| 121 | |
| 122 | class LayerNorm(nn.Module): |
| 123 | "Construct a layernorm module (See citation for details)." |
| 124 | |
| 125 | def __init__(self, features, eps=1e-6): |
| 126 | super(LayerNorm, self).__init__() |
| 127 | self.a_2 = nn.Parameter(torch.ones(features)) |
| 128 | self.b_2 = nn.Parameter(torch.zeros(features)) |
| 129 | self.eps = eps |
| 130 | |
| 131 | def forward(self, x): |
| 132 | mean = x.mean(-1, keepdim=True) |
| 133 | std = x.std(-1, keepdim=True) |
| 134 | return self.a_2 * (x - mean) / (std + self.eps) + self.b_2 |
| 135 | |
| 136 | |
| 137 | class SublayerConnection(nn.Module): |
| 138 | """ |
| 139 | A residual connection followed by a layer norm. |
| 140 | Note for code simplicity the norm is first as opposed to last. |
| 141 | """ |
| 142 | |
| 143 | def __init__(self, size, dropout): |
| 144 | super(SublayerConnection, self).__init__() |
| 145 | self.norm = LayerNorm(size) |
| 146 | self.dropout = nn.Dropout(dropout) |
| 147 | |
| 148 | def forward(self, x, sublayer): |
| 149 | "Apply residual connection to any sublayer with the same size." |
| 150 | return x + self.dropout(sublayer(self.norm(x))) |
| 151 | |
| 152 | |
| 153 | class EncoderLayer(nn.Module): |
| 154 | "Encoder is made up of self-attn and feed forward (defined below)" |
| 155 | |
| 156 | def __init__(self, size, self_attn, feed_forward, dropout): |
| 157 | super(EncoderLayer, self).__init__() |
| 158 | self.self_attn = self_attn |
| 159 | self.feed_forward = feed_forward |
| 160 | self.sublayer = clones(SublayerConnection(size, dropout), 2) |
| 161 | self.size = size |
| 162 | |
| 163 | def forward(self, x, mask): |
| 164 | "Follow Figure 1 (left) for connections." |
| 165 | x = self.sublayer[0](x, lambda x: self.self_attn(x, x, x, mask)) |
| 166 | return self.sublayer[1](x, self.feed_forward) |
| 167 | |
| 168 | |
| 169 | class Encoder(nn.Module): |
| 170 | "Core encoder is a stack of N layers" |
| 171 | |
| 172 | def __init__(self, layer, N): |
| 173 | super(Encoder, self).__init__() |
| 174 | self.layers = clones(layer, N) |
| 175 | self.norm = LayerNorm(layer.size) |
| 176 | |
| 177 | def forward(self, x, mask): |
| 178 | "Pass the input (and mask) through each layer in turn." |
| 179 | for layer in self.layers: |
| 180 | x = layer(x, mask) |
| 181 | return self.norm(x) |