clones(module, N): 같은 모듈을 N개 deepcopy한다. 모양은 같지만 가중치는 따로 갖는다. 앞으로 층을 쌓을 때마다 쓴다.
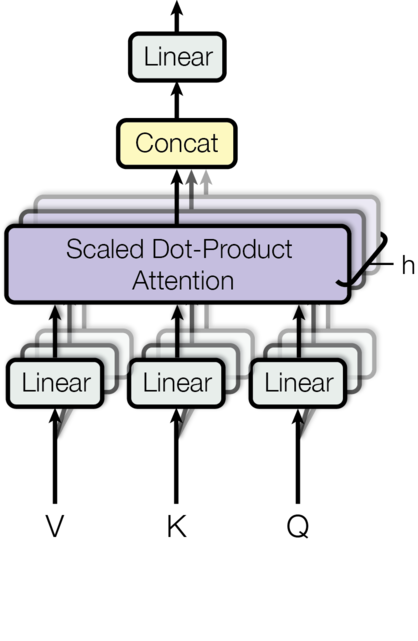
MultiHeadedAttention: nn.Linear 4개(W_Q, W_K, W_V, W_O)를 갖는다. head 8개를 반복문으로 돌리지 않고, view + transpose로 head를 배치 차원처럼 앞으로 빼서 한 번의 행렬곱으로 처리하는 게 핵심이다. 계산한 가중치는 self.attn에 남겨 둔다.
attention에 dropout 인자 추가: 학습 때 가중치 일부를 0으로 만들어 과적합을 줄인다.
실행 결과에서 볼 것
입력과 출력의 모양이 같다. 그래서 이 블록을 몇 층이든 쌓을 수 있다.
(2, 10, 512) → (2, 10, 8, 64) → (2, 8, 10, 64)로 모양이 바뀌는 과정.
같은 가중치를 넣었을 때 PyTorch 내장 nn.MultiheadAttention과 결과 차이가 1e-7 수준이다. 우리가 만든 것이 표준 구현과 같은 계산이라는 뜻이다.
W_O 실험: 이어 붙인 head 출력에 W_O를 곱한 값이 ours(y, y, y)와 정확히 같고, head마다 W_O의 자기 몫을 곱해 더한 값과도 같다(차이 1e-7 수준).
코드 변화
+52−1 · 파일 전체 73줄
이전 단계의 transformer.py와 비교했다. 초록 줄이 새로 생긴 줄, 빨간 줄이 사라진 줄이다.
입력           : (2, 10, 512)
출력           : (2, 10, 512)  ← 입력과 같은 모양
head별 가중치  : (2, 8, 10, 10)  (batch, head, query, key)
head 하나의 d_k: 64 = 512 / 8

파라미터 수: 1,050,624  = 4 × (512×512 + 512)  (W_Q, W_K, W_V, W_O)

1) 프로젝션 후 head로 쪼개는 모양 변화
   linear(x)               (2, 10, 512)
   .view(B, -1, h, d_k)     (2, 10, 8, 64)
   .transpose(1, 2)         (2, 8, 10, 64)  ← head가 batch처럼 앞으로

2) PyTorch 내장 nn.MultiheadAttention과 같은 계산인가?
   최대 차이: 9.69e-08

3) W_O(linears[-1])는 head들의 결과를 섞는다
   concat 모양: (1, 6, 32)  → W_O 통과 → (1, 6, 32)
   ours(y, y, y)와 차이: 0.0e+00
   Σ head_i @ W_O의 i번째 블록 + bias 와 차이: 6.0e-08
   → 출력 한 칸 한 칸이 head 4개 모두의 결과를 섞은 값이다
참고
forward가 하는 일
forward는 모듈을 함수처럼 부를 때 실행되는 본체다. 데모에서 mha = MultiHeadedAttention(h=8, d_model=512)(mha = Multi-Head Attention)로 만든 뒤 mha(x, x, x)라고 부르면 이 함수가 돈다. 코드 주석의 1) 2) 3) 순서로 읽으면 된다. 모양은 데모 기준(문장 2개, 토큰 10개, d_model 512, head 8개)이다.
0) 마스크에 head 축 추가mask.unsqueeze(1): (2, 1, 10) → (2, 1, 1, 10). 크기 1인 축은 브로드캐스트되므로 head 8개에 같은 마스크가 걸린다.
1) head로 나누기: W_Q·W_K·W_V(linears[0..2])로 투영한 (2, 10, 512)를 .view(2, -1, 8, 64)로 head 8개 × 64칸으로 자르고 .transpose(1, 2)로 (2, 8, 10, 64)를 만든다. head가 앞으로 나와 "표를 쌓은 장 수"가 되므로, 1단계 attention이 head 8개를 한 번에 계산한다.
3) 합치기: .transpose(1, 2)로 (2, 10, 8, 64)로 되돌리고 .view(2, -1, 512)로 head를 옆으로 이어 붙인(Concat) 뒤 W_O(linears[-1])를 통과시킨다. 중간의 .contiguous()는 transpose로 흐트러진 메모리 배치를 다시 정리하는 것이다. 이게 없으면 view가 에러를 낸다.
전체 흐름을 모양으로 따라가면 이렇다. 점선 상자 안이 1단계에서 만든 attention 함수다.
마지막의 del query, key, value는 중간 텐서를 일찍 놓아 메모리를 아끼려는 줄이고, 결과에는 영향이 없다.
W_O(self.linears[-1])의 역할
head 8개의 결과(64차원씩)를 이어 붙이면 다시 512차원이 되지만, 이 상태에서는 0~63번 칸에 head 1 결과만, 64~127번 칸에 head 2 결과만 들어 있어 head끼리 정보가 섞이지 않는다. 마지막 nn.Linear(512, 512)가 이 512칸 전체를 섞어서 출력 한 칸 한 칸이 모든 head의 결과를 반영하게 만든다. 수식으로는 $\mathrm{Concat}(\mathrm{head_1}, ..., \mathrm{head_h})W^O = \sum_i \mathrm{head_i} W^O_i$, 즉 head마다 W_O의 자기 몫(64행)을 곱해 더하는 것과 같다. 출력 크기를 다시 d_model로 맞춰 다음 층에 넘기는 역할도 한다.
self.linears[-1](x)가 동작하는 방식
self.linears[-1]은 weight(512×512)와 bias(512)를 가진 nn.Linear객체다. 객체에 (x)를 붙이면 부모 클래스 nn.Module의 __call__이 실행되고, 그 안에서 forward를 부른다. 그래서 우리는 forward만 정의하면 된다(MultiHeadedAttention도 같은 방식이다). nn.Linear.forward는 x @ weight.T + bias이고, 마지막 축만 계산에 쓴다. (2, 10, 512)라면 512짜리 벡터 20개 각각에 같은 W_O를 따로 곱하므로 출력도 (2, 10, 512)다.
head 축을 앞으로 빼는 이유 (transpose(1, 2))
attention은 마지막 두 축을 "표 한 장"으로 보고 계산한다. view 직후 (2, 10, 8, 64)는 마지막 두 축이 (head, d_k)라서, 그대로 넣으면 토큰끼리가 아니라 head끼리 비교한 8×8 표가 나온다. head 8은 비교 대상이 아니라 "같은 계산을 따로 몇 번 하느냐"이므로 문장 수처럼 앞으로 빼서 묶음 축으로 둔다.
점수표 (2, 8, 10, 10)의 의미
attention 안의 query @ key.transpose(-2, -1) 결과다. 문장 2개 × head 8개 = 16장의 10×10 "토큰 ↔ 토큰" 점수표로, 행은 query 토큰, 열은 key 토큰이다. 데모 출력의 head별 가중치 (2, 8, 10, 10)은 여기에 softmax를 건 것이다.
마스크에 unsqueeze(1)을 하는 이유
PyTorch는 모양이 다른 텐서를 오른쪽 끝부터 맞춘다(브로드캐스트). 3차원 마스크 (2, 1, 10)을 그대로 쓰면 마스크의 문장 축이 점수표의 head 축에 붙는다. 문장 수와 head 수가 다르면 에러가 나고, 같으면(둘 다 8) 에러 없이 엉뚱한 칸이 가려진다. unsqueeze(1)로 head 자리에 크기 1인 축을 끼우면 문장 축끼리 맞고, 모든 head에 같은 마스크가 퍼진다. 원본 주석 "Same mask applied to all h heads"가 이 뜻이다.
@ 연산
a @ b는 파이썬의 행렬곱 연산자로, PyTorch에서는 torch.matmul(a, b)와 같다(실제 코드는 torch.matmul로 쓰여 있다). 3차원 이상이면 앞 축은 묶음으로 두고 마지막 두 축끼리만 곱한다. 곱하는 규칙은 왼쪽의 마지막 축과 오른쪽의 앞 축(행렬이면 행)을 곱해서 더한다이다. 그래서 둘의 길이가 같아야 하고, 그 축은 결과에서 사라진다. 예: nn.Linear의 x @ weight.T는 (2, 10, 512) @ (512, 512) → (2, 10, 512)로, x의 마지막 축 512만 섞이고 (2, 10)은 그대로 남는다. (torch.matmul 문서)